手動キーワードリサーチは、2026年の検索環境では通用しない。
バイヤーは検索バーにクエリを入力する前に、ChatGPT、Perplexity、Google AI Overviewsに直接質問している。これらのエンジンは完全一致の文字列ではなく、抽出されたエンティティとトピックから回答を生成する。もしあなたのチームがまだスプレッドシートと勘に頼ってキーワードを選んでいるなら、もはや存在しなくなりつつある検索エンジン向けに最適化していることになる。
キーワード抽出——コンテンツと市場を実際に記述する用語、エンティティ、インテントを自動で識別するプロセス——がその解決策だ。正しく実装すれば、数週間の手動リサーチを、従来型SEOとGenerative Engine Optimization(GEO)の両方に対応する再現可能なパイプラインに置き換えられる。2社のB2B企業がROIが机上の空論ではないことを証明している:Lyzr.aiはNLP駆動のキーワード・エンティティ抽出をコンテンツ監査に重ねた結果、3ヶ月でオーガニックトラフィック150%増・インプレッション200%増を達成し、CortexはNLPトピックモデリングを使って競合がすでにランクインしているコンテンツギャップを埋め、6ヶ月で総サイトトラフィック3倍・適格B2Bリード30%増を実現した。
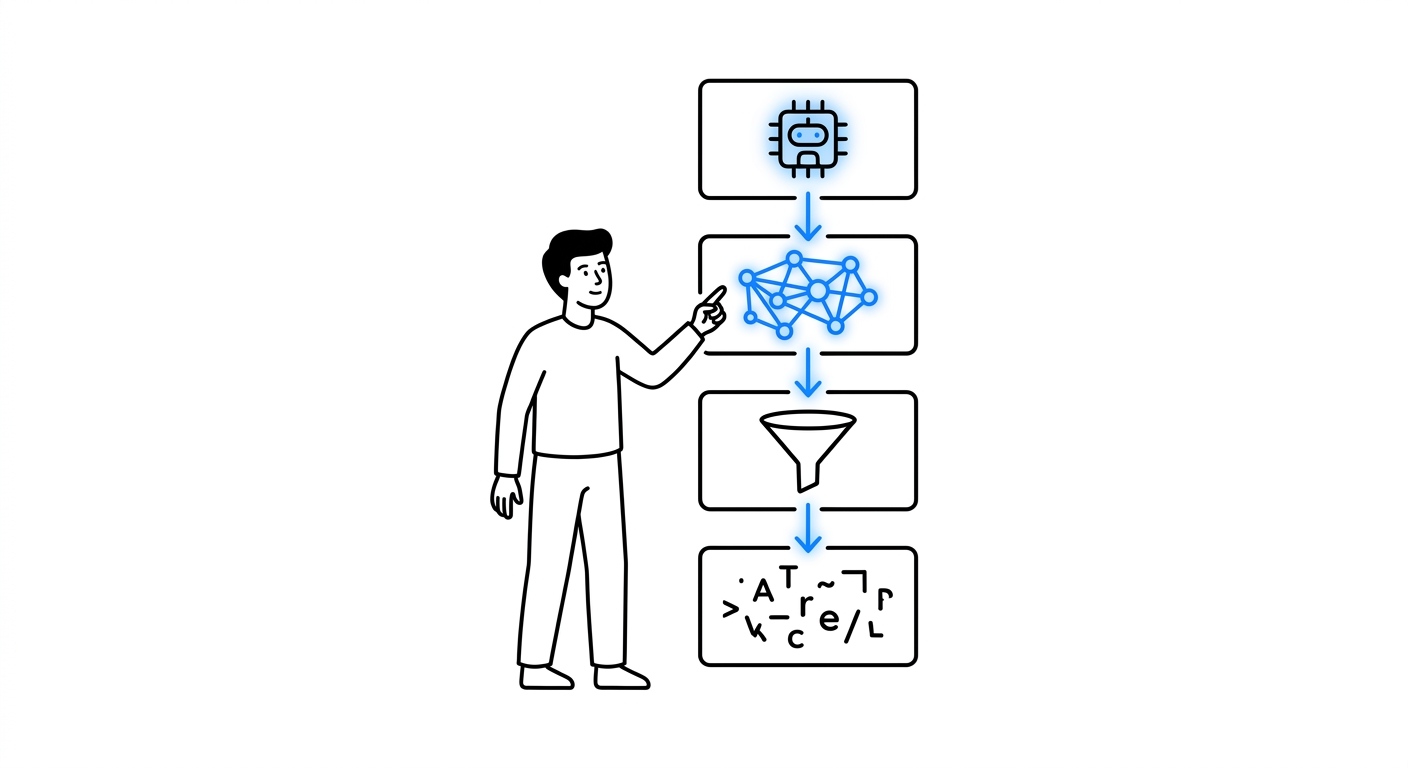
4層抽出アーキテクチャ
最新のパイプラインは単一のアルゴリズムに依存しない。速度とセマンティック深度のトレードオフを調整しながら、4つのレイヤーを積み重ねる:
- 統計フィルタリング — spaCy POSタグ付け、YAKE!、RAKE、TextRankが生テキスト(営業通話の書き起こし、競合ページ、コミュニティスレッド)をスキャンし、ほぼゼロレイテンシで候補用語を生成する。
- セマンティック埋め込み — KeyBERTがコサイン類似度によるドキュメント埋め込みに対して候補をスコアリング。Maximal Marginal Relevance(MMR)が「B2B SaaSソフトウェア」vs.「B2B SaaSソリューション」のようなほぼ重複を排除する。BERTopic/Top2Vecが非構造化テキストを潜在テーマにクラスタリングする。
- エンティティ認識 — カスタムspaCyまたはGLiNERモデルがブランド名、製品機能、競合エンティティをタグ付けし、ナレッジグラフにリンクする。これにより、コンテンツシステムは単なる文字列ではなく関係性を理解できるようになる。
- LLM推論 — GPT-4oまたはClaude級のモデルが、最初の3層が検出したすべてに対して、インテント、ペルソナ、ファネルステージ、GEO/AEO引用可能性を付加する。
出力はキーワードリストではない。バイヤー関連性でランク付けされたエンティティとインテントの構造化マップ——AI回答エンジンが誰を引用するか決定するのと同じ入力フォーマットだ。
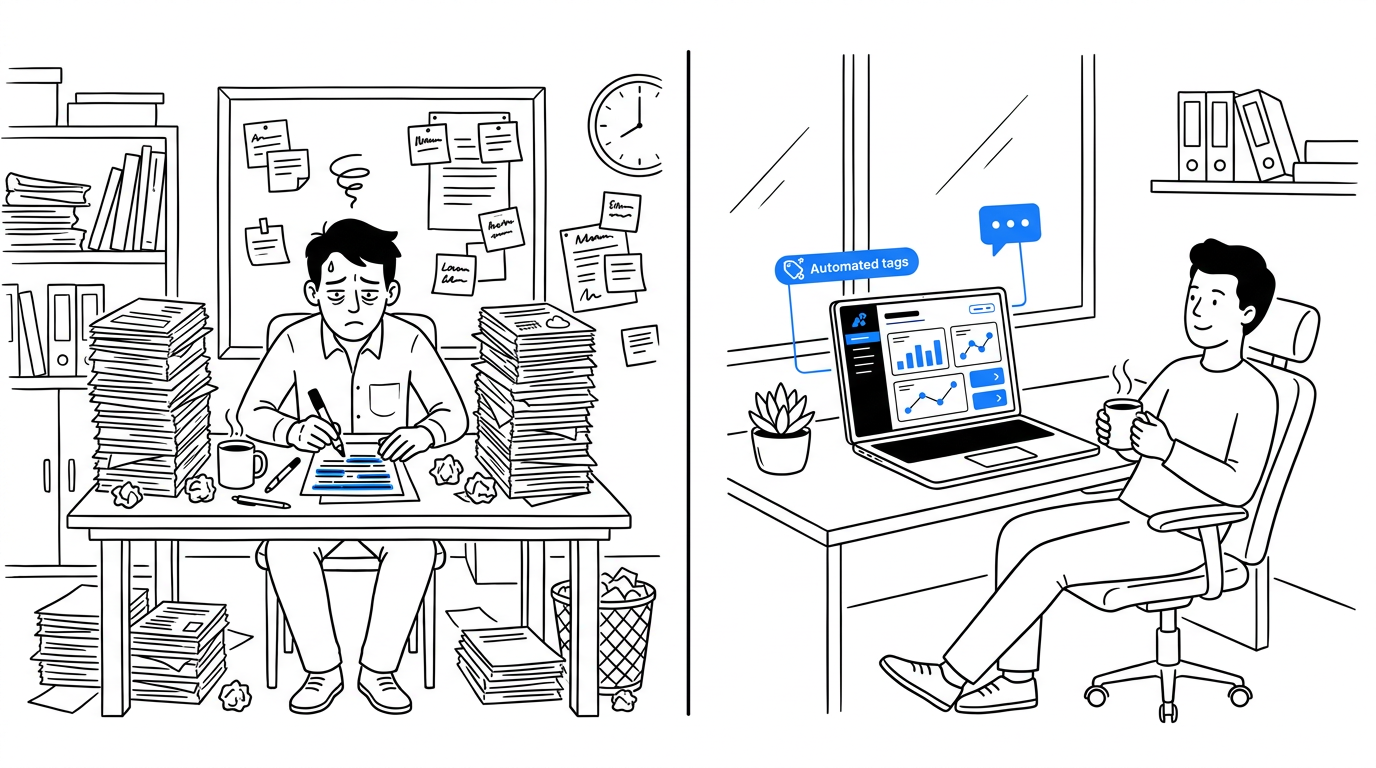
手動 vs. AI駆動の抽出
| 手動リサーチ | AI駆動の抽出 | |
|---|---|---|
| 10記事あたりの所要時間 | 15〜20時間 | 1〜2時間 |
| カバー範囲の深さ | アナリストの既知用語 | 完全なセマンティック+エンティティグラフ |
| 競合ギャップ検出 | スポットチェック | 体系的・毎回クロール |
| GEO/AI引用対応度 | ほとんどスコア化されない | パッセージごとにスコア化 |
| コンテンツ速度に応じたスケール | 不可 | 可能 |
Cortexはこのギャップを直接体験した:手動リサーチでは週2記事が限界だった。NLP駆動のトピックマッピングに切り替えた後、同じ人員で週5〜6本の深い記事を制作できるようになり、トラフィックの80%がオーガニック検索からのものとなった。
今月実行できる3フェーズワークフロー
フェーズ1 — 収集。 最も購買意欲の高いソースから生テキストを取得:営業通話の書き起こし、サポートチケット、競合の上位ランキングページ、レビューサイト。レイヤー1の統計抽出を実行し、数日ではなく数分で候補プールを生成する。
フェーズ2 — 構造化。 候補をセマンティック埋め込みとエンティティ認識に通す。トピッククラスターにグループ化し、各エンティティタイプ(製品、機能、競合、ユースケース)をタグ付けし、競合がすでにカバーしているが自社が欠けているサブトピックをフラグ付けする。
フェーズ3 — 優先順位付けとブリーフ作成。 LLM推論を重ねて、各クラスターをバイヤーインテント、ファネルステージ、引用可能性でスコアリングし、コンテンツブリーフを自動生成する。ここでConcat ProのSEO/GEOエージェントが手動のボトルネックを完全に排除する——製品、オーディエンス、市場コンテキストを取り込み、重要なエンティティとキーワードを抽出し、人間が初稿を書くことなく、プラットフォーム対応・AI回答対応のドラフトを出力する。
1記事のブリーフを作成する前に、予測トラフィック向上をコンバージョン率計算ツールで現在のランディングページのベースラインと照合しよう。「キーワードが増えた」を、グロースリードが実際に承認できる防御可能な収益予測に変換できる。
よくある間違い
- 文字列を最適化し、エンティティを最適化しない。 抽出パイプラインがレイヤー1で止まっている場合、それはより良いツールを使ったキーワードスタッフィングに過ぎない。
- ブランド言及シグナルを無視する。 バックリンクとAI引用可能性の相関は約0.27に過ぎないが、YouTubeのブランド言及は約0.74の相関がある。抽出戦略が動画やコミュニティコンテンツでブランドがどこでどう言及されているかを追跡していなければ、間違ったシグナルを最適化していることになる。
- 競合ギャップ分析を省略する。 Cortexの最大のレバーは新しいキーワードではなく、競合がすでにランクインしていて自社が完全に欠いていたサブトピックだった。
- 抽出を一回限りのプロジェクトとして扱う。 バイヤーの言語は四半期ごとに変化する。パイプラインには年次リフレッシュではなく、定期的な再実行が必要だ。
- ファネルステージのタグ付けがない。 インテント分類のないキーワードリストは、優先順位付けの問題をライターに先送りしているだけだ。
なぜこれがAI検索で特に重要なのか
AI Overviewsは現在、Googleクエリの半数以上に表示され、月間15億人のユーザーにリーチしている。この2026年ChatGPT時代のSEO戦略ウォークスルーで、核心的な教訓は抽出データが示す内容と完全に一致する:エンジンはバックリンクが最も多いブランドではなく、エンティティと言及がウェブ全体で構造的に明確なブランドを引用する。Googleスタイルのボリュームメトリクスで止まるキーワード抽出はこれを完全に見逃す——AI生成回答の中で引用されるために必要なのは、ページ1にランクインするだけでなく、エンティティとインテントのレイヤーだ。
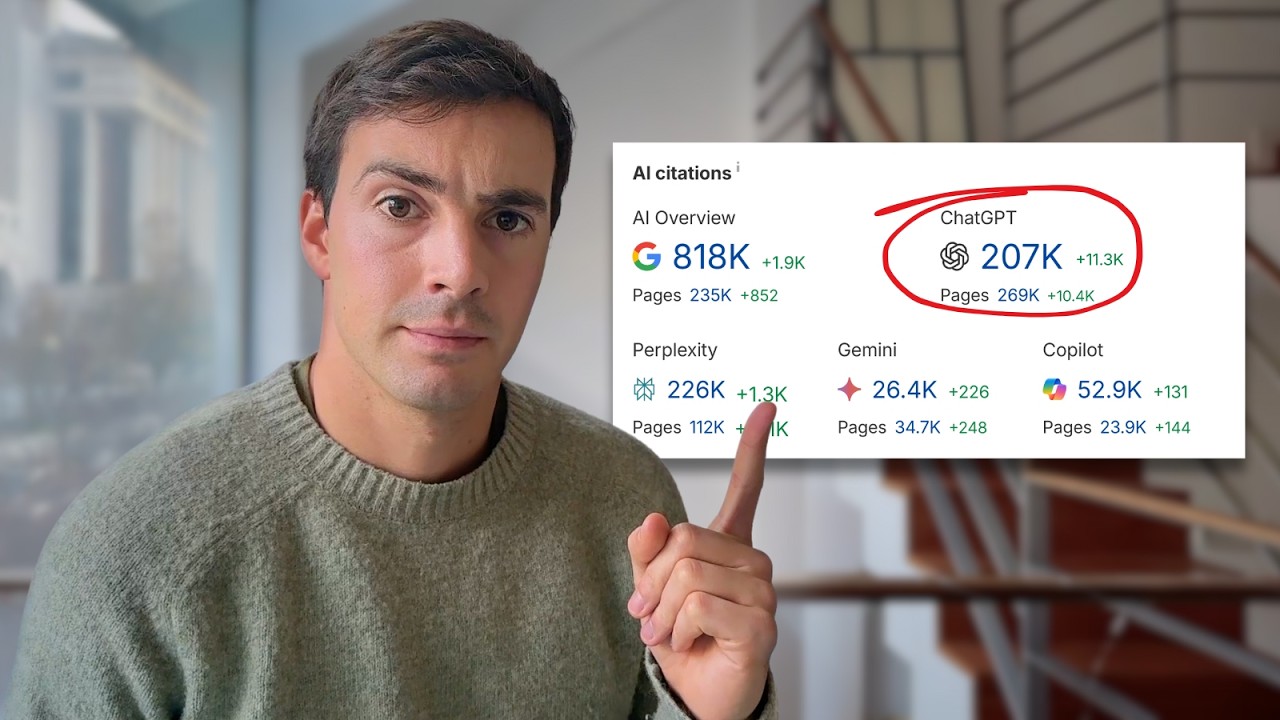 視聴:「My ChatGPT AI SEO Strategy (works in 2026)」 — AI検索可視性のためのブランド言及・エンティティシグナルについて。
結論
抽出はインフラであり、一回限りのリサーチタスクではない。4層パイプライン——統計フィルタリング、セマンティック埋め込み、エンティティ認識、LLM推論——を一度構築すれば、下流のすべてのコンテンツ、SEO、GEOの意思決定がより速く、より防御可能になる。LyzrとCortexは競合より多く書いたのではなく、より良く構造化した。Concat ProのSEO/GEOエージェントでプロジェクトを始めよう——自社の製品と市場コンテキストに対してこのパイプラインを実行できる。
参考文献
- Concat Pro — SEO/GEOエージェント
- Concat Pro — コンバージョン率計算ツール
- YouTube — 「My ChatGPT AI SEO Strategy (works in 2026)」