수동 키워드 리서치는 2026년 검색 환경에서 살아남지 못한다.
구매자는 검색창에 쿼리를 입력하기 전에 ChatGPT, Perplexity, Google AI Overviews에 직접 질문을 던진다. 이 엔진들은 정확히 일치하는 문자열이 아닌 추출된 엔티티와 토픽으로 답변을 생성한다. 팀이 여전히 스프레드시트와 직감으로 키워드를 뽑고 있다면, 점점 존재하지 않게 되는 검색엔진에 최적화하고 있는 것이다.
키워드 추출——콘텐츠와 시장을 실제로 설명하는 용어, 엔티티, 인텐트를 자동 식별하는 프로세스——이 해결책이다. 올바르게 구현하면 수 주간의 수동 리서치를 기존 SEO와 Generative Engine Optimization(GEO) 모두에 활용할 수 있는 반복 가능한 파이프라인으로 대체할 수 있다. 2개의 실제 B2B 기업이 ROI가 이론에 그치지 않음을 입증한다: Lyzr.ai는 NLP 기반 키워드·엔티티 추출을 콘텐츠 감사에 적용한 후 3개월 만에 오가닉 트래픽 150%, 노출 200% 증가를 달성했고, Cortex는 NLP 토픽 모델링으로 경쟁사가 이미 랭킹하고 있는 콘텐츠 갭을 메워 6개월 만에 총 사이트 트래픽 3배, 적격 B2B 리드 30% 증가를 실현했다.
4계층 추출 아키텍처
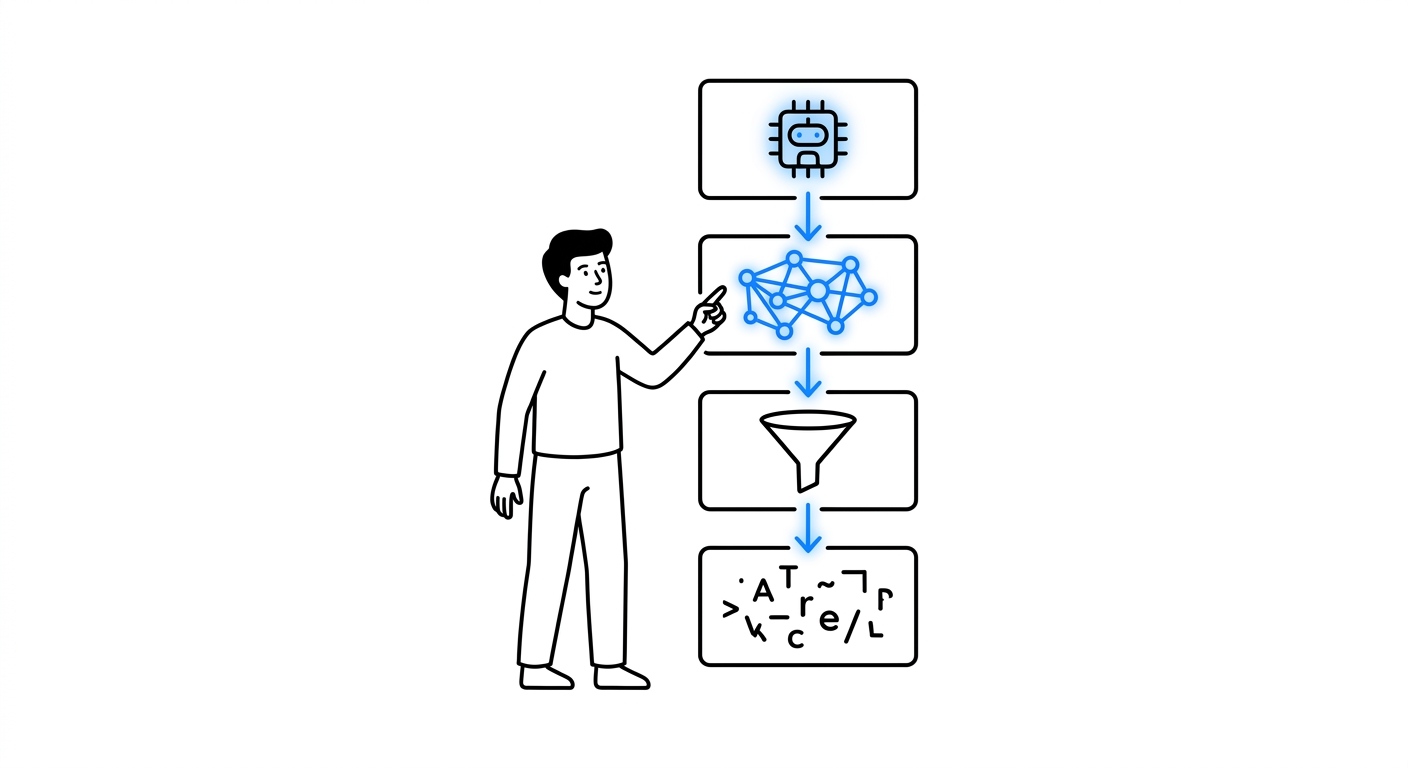
최신 파이프라인은 단일 알고리즘에 의존하지 않는다. 속도와 시맨틱 깊이 사이의 트레이드오프를 조절하며 4개 레이어를 쌓는다:
- 통계 필터링 — spaCy POS 태깅, YAKE!, RAKE, TextRank가 원시 텍스트(영업 통화 녹취록, 경쟁사 페이지, 커뮤니티 스레드)를 스캔하여 거의 제로 레이턴시로 후보 용어를 생성한다.
- 시맨틱 임베딩 — KeyBERT가 코사인 유사도를 통해 문서 임베딩에 대해 후보를 스코어링한다. Maximal Marginal Relevance(MMR)가 "B2B SaaS 소프트웨어" vs. "B2B SaaS 솔루션" 같은 거의 중복을 제거한다. BERTopic/Top2Vec가 비정형 텍스트를 잠재 테마로 클러스터링한다.
- 엔티티 인식 — 커스텀 spaCy 또는 GLiNER 모델이 브랜드명, 제품 기능, 경쟁사 엔티티를 태깅하고 지식 그래프에 연결하여 콘텐츠 시스템이 단순 문자열이 아닌 관계를 이해하게 한다.
- LLM 추론 — GPT-4o 또는 Claude급 모델이 앞선 3개 레이어가 도출한 모든 것 위에 인텐트, 페르소나, 퍼널 단계, GEO/AEO 인용 가능성을 부여한다.
출력물은 키워드 목록이 아니다. 구매자 관련성으로 랭킹된 엔티티와 인텐트의 구조화된 맵——AI 답변 엔진이 누구를 인용할지 결정할 때 사용하는 것과 동일한 입력 형식이다.
수동 vs. AI 기반 추출
| 수동 리서치 | AI 기반 추출 | |
|---|---|---|
| 10개 기사당 소요 시간 | 15~20시간 | 1~2시간 |
| 커버리지 깊이 | 분석가가 아는 용어 | 전체 시맨틱 + 엔티티 그래프 |
| 경쟁사 갭 탐지 | 스팟 체크 | 체계적, 매 크롤링마다 |
| GEO/AI 인용 준비도 | 거의 스코어링 안 됨 | 패시지별 스코어링 |
| 콘텐츠 속도에 따른 확장 | 불가 | 가능 |
Cortex는 이 격차를 직접 체감했다: 수동 리서치로는 주 2개 기사가 한계였다. NLP 기반 토픽 매핑으로 전환한 후 동일 인원으로 주 5~6개의 심도 있는 기사를 제작할 수 있었고, 트래픽의 80%가 오가닉 검색에서 유입되게 되었다.
이번 달 실행할 수 있는 3단계 워크플로우
1단계 — 수집. 가장 구매 의도가 높은 소스에서 원시 텍스트를 가져온다: 영업 통화 녹취록, 고객 지원 티켓, 경쟁사 상위 랭킹 페이지, 리뷰 사이트. 레이어 1 통계 추출을 실행하여 며칠이 아닌 몇 분 만에 원시 후보 풀을 생성한다.
2단계 — 구조화. 후보를 시맨틱 임베딩과 엔티티 인식에 통과시킨다. 토픽 클러스터로 그룹화하고, 각각에 엔티티 유형(제품, 기능, 경쟁사, 유즈케이스)을 태깅하며, 경쟁사가 이미 커버하고 있지만 우리가 빠뜨린 하위 토픽을 플래그 처리한다.
3단계 — 우선순위 지정 및 브리프 작성. LLM 추론을 레이어링하여 각 클러스터를 구매자 인텐트, 퍼널 단계, 인용 가능성으로 스코어링한 후 콘텐츠 브리프를 자동 생성한다. 바로 여기서 Concat Pro의 SEO/GEO 에이전트가 수동 병목을 완전히 제거한다——제품, 오디언스, 시장 컨텍스트를 수집하고 중요한 엔티티와 키워드를 추출하여 사람이 초안을 작성할 필요 없이 플랫폼 대응·AI 답변 대응 드래프트를 출력한다.
단 하나의 기사 브리프를 작성하기 전에, 예상 트래픽 증가분을 전환율 계산기로 현재 랜딩 페이지 베이스라인과 대조하라. "키워드가 늘었다"를 그로스 리드가 실제로 승인할 수 있는 방어 가능한 매출 예측으로 전환할 수 있다.
흔한 실수
- 엔티티가 아닌 문자열에 최적화한다. 추출 파이프라인이 레이어 1에서 멈춘다면, 더 좋은 도구로 키워드 스터핑을 하고 있을 뿐이다.
- 브랜드 멘션 시그널을 무시한다. 백링크와 AI 인용 가능성의 상관관계는 약 0.27에 불과하지만, YouTube 브랜드 멘션은 약 0.74의 상관관계를 보인다. 추출 전략이 동영상과 커뮤니티 콘텐츠에서 브랜드가 어디서 어떻게 언급되는지 추적하지 않는다면, 잘못된 시그널을 최적화하고 있는 것이다.
- 경쟁사 갭 분석을 건너뛴다. Cortex의 가장 큰 레버는 새로운 키워드가 아니라 경쟁사가 이미 랭킹하고 있지만 자사가 완전히 빠뜨린 하위 토픽이었다.
- 추출을 일회성 프로젝트로 취급한다. 구매자 언어는 분기마다 변한다. 파이프라인에는 연간 갱신이 아닌 정기적인 재실행이 필요하다.
- 퍼널 단계 태깅이 없다. 인텐트 분류 없는 키워드 목록은 우선순위 지정 문제를 라이터에게 떠넘길 뿐이다.
이것이 AI 검색에서 특히 중요한 이유
AI Overviews는 현재 모든 Google 쿼리의 절반 이상에 표시되며, 월 15억 사용자에게 도달한다. 이 2026년 ChatGPT 시대 SEO 전략 워크스루에서 핵심 교훈은 추출 데이터가 보여주는 것과 정확히 일치한다: 엔진은 백링크가 가장 많은 브랜드가 아니라 엔티티와 멘션이 웹 전체에서 구조적으로 명확한 브랜드를 인용한다. Google 스타일의 볼륨 메트릭에서 멈추는 키워드 추출은 이를 완전히 놓친다——AI 생성 답변 안에서 인용되기 위해 필요한 것은 페이지 1에 랭킹되는 것만이 아니라 엔티티와 인텐트 레이어다.
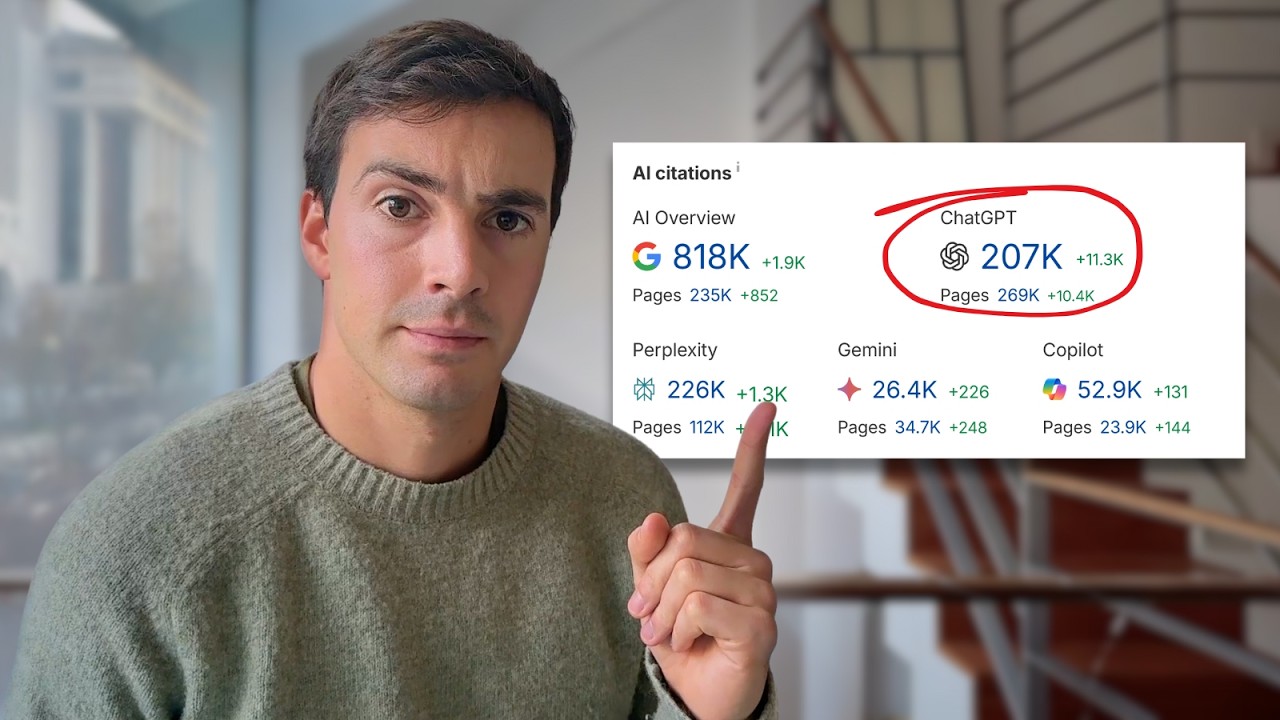 시청: 「My ChatGPT AI SEO Strategy (works in 2026)」 — AI 검색 가시성을 위한 브랜드 멘션 및 엔티티 시그널에 대해.
결론
추출은 인프라이지, 일회성 리서치 과제가 아니다. 4계층 파이프라인——통계 필터링, 시맨틱 임베딩, 엔티티 인식, LLM 추론——을 한 번 구축하면 이후 모든 콘텐츠, SEO, GEO 의사결정이 더 빠르고 방어 가능해진다. Lyzr과 Cortex는 경쟁사보다 더 많이 쓴 게 아니라 더 잘 구조화했다. Concat Pro의 SEO/GEO 에이전트로 프로젝트를 시작하여 자사 제품과 시장 컨텍스트에 대해 이 파이프라인을 실행하라.
참고 문헌
- Concat Pro — SEO/GEO 에이전트
- Concat Pro — 전환율 계산기
- YouTube — 「My ChatGPT AI SEO Strategy (works in 2026)」