Pesquisa manual de palavras-chave não sobrevive ao cenário de busca de 2026.
Compradores agora perguntam diretamente ao ChatGPT, Perplexity e Google AI Overviews antes de sequer digitar uma consulta na barra de pesquisa — e esses motores respondem a partir de entidades e tópicos extraídos, não de correspondências exatas de strings. Se seu time ainda puxa palavras-chave de uma planilha e do instinto, vocês estão otimizando para um mecanismo de busca que cada vez mais deixa de existir.
Extração de palavras-chave — a identificação automatizada dos termos, entidades e intenções que realmente descrevem seu conteúdo e seu mercado — é a solução. Bem executada, ela substitui semanas de pesquisa manual por um pipeline repetível que alimenta tanto o SEO clássico quanto a Generative Engine Optimization (GEO). Duas empresas B2B reais comprovam que o ROI não é teórico: a Lyzr.ai cresceu o tráfego orgânico 150% e as impressões 200% em três meses ao aplicar extração de keywords e entidades via NLP em suas auditorias de conteúdo, e a Cortex triplicou o tráfego total do site e cresceu leads B2B qualificados em 30% em seis meses usando modelagem de tópicos NLP para fechar gaps de conteúdo nos quais concorrentes já ranqueavam.
A Arquitetura de Extração em 4 Camadas
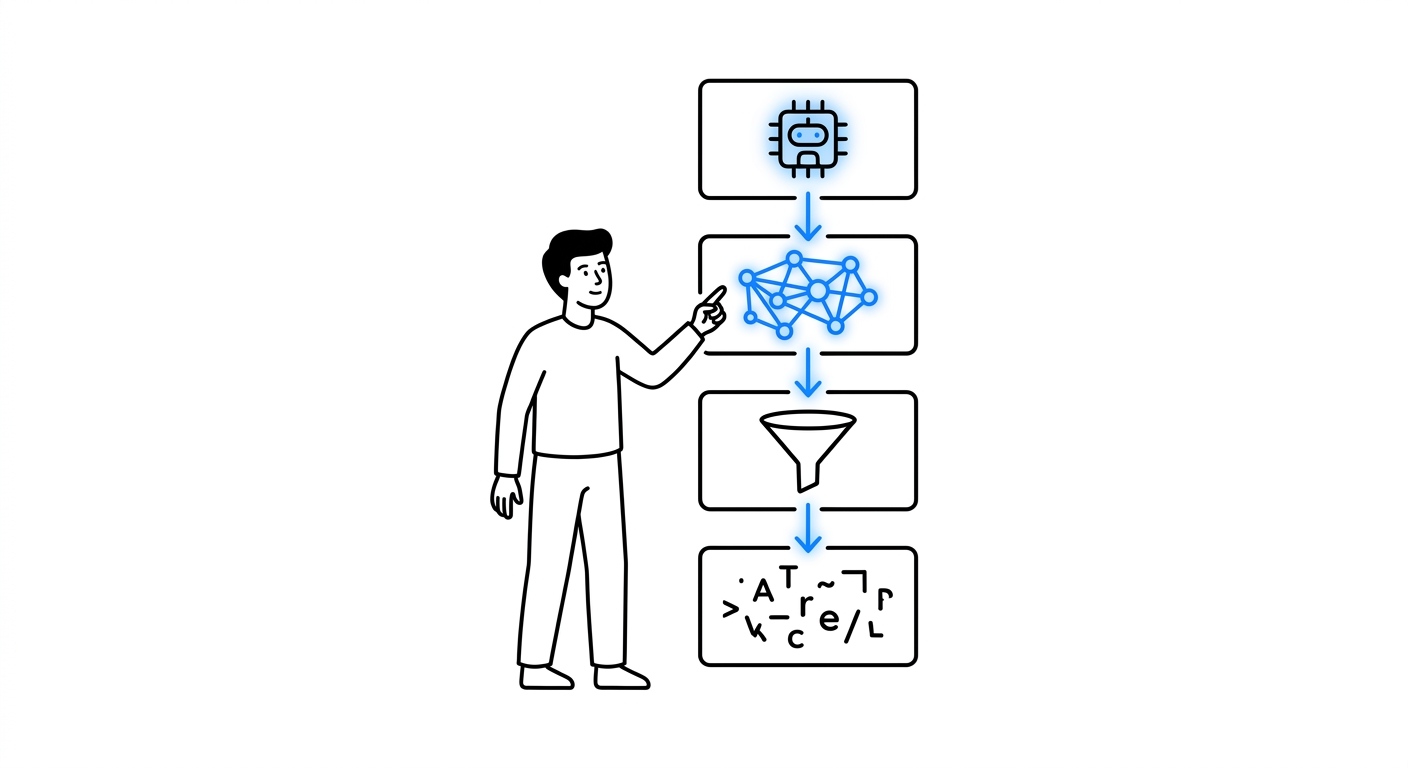
Pipelines modernos não dependem de um único algoritmo. Eles empilham quatro camadas, cada uma balanceando velocidade e profundidade semântica:
- Filtragem estatística — spaCy POS tagging, YAKE!, RAKE e TextRank escaneiam texto bruto (transcrições de calls de vendas, páginas de concorrentes, threads de comunidades) e geram termos candidatos em latência quase zero.
- Embeddings semânticos — KeyBERT pontua candidatos contra embeddings de documentos via similaridade de cosseno; Maximal Marginal Relevance (MMR) elimina quase-duplicatas como "software B2B SaaS" vs. "solução B2B SaaS". BERTopic/Top2Vec clusterizam texto não estruturado em temas latentes.
- Reconhecimento de entidades — modelos customizados spaCy ou GLiNER tagueiam nomes de marca, funcionalidades de produto e entidades concorrentes, vinculando-os a um knowledge graph para que o sistema de conteúdo entenda relações, não apenas strings.
- Raciocínio LLM — um modelo classe GPT-4o ou Claude adiciona intenção, persona, estágio de funil e potencial de citação GEO/AEO sobre tudo que as três primeiras camadas identificaram.
A saída não é uma lista de palavras-chave. É um mapa estruturado de entidades e intenções ranqueadas por relevância para o comprador — o mesmo formato de entrada que motores de resposta por IA usam para decidir quem é citado.
Manual vs. Extração com IA
| Pesquisa Manual | Extração com IA | |
|---|---|---|
| Tempo por 10 artigos | 15-20 horas | 1-2 horas |
| Profundidade de cobertura | Termos conhecidos pelo analista | Grafo semântico + de entidades completo |
| Detecção de gaps competitivos | Checagens pontuais | Sistemática, a cada crawl |
| Prontidão para citação GEO/IA | Raramente pontuada | Pontuada por passagem |
| Escala com velocidade de conteúdo | Não | Sim |
A Cortex sentiu esse gap diretamente: pesquisa manual limitava o time a dois artigos por semana. Após migrar para mapeamento topical via NLP, eles escalaram para cinco ou seis artigos de alta profundidade por semana com o mesmo headcount — e 80% do tráfego agora vem de busca orgânica.
Workflow de 3 Fases que Você Executa Neste Mês
Fase 1 — Coleta. Extraia texto bruto das fontes de maior intenção: transcrições de calls de vendas, tickets de suporte, páginas mais bem ranqueadas de concorrentes e sites de avaliação. Rode a extração estatística da Camada 1 para gerar um pool de candidatos em minutos, não em dias.
Fase 2 — Estruturação. Passe os candidatos por embedding semântico e reconhecimento de entidades. Agrupe-os em clusters temáticos, taguei cada um com o tipo de entidade (produto, funcionalidade, concorrente, caso de uso) e sinalize subtópicos que concorrentes já cobrem e você não.
Fase 3 — Priorização e briefing. Adicione raciocínio LLM para pontuar cada cluster em intenção do comprador, estágio de funil e potencial de citação, depois gere briefings de conteúdo automaticamente. É aqui que o Agente SEO/GEO do Concat Pro elimina completamente o gargalo manual — ele ingere seu produto, audiência e contexto de mercado, extrai as entidades e palavras-chave relevantes e gera drafts prontos para plataforma e prontos para respostas de IA, sem que um humano faça o primeiro rascunho.
Antes de briefar um único artigo, rode a projeção de aumento de tráfego na calculadora de taxa de conversão contra o baseline atual da sua landing page — isso transforma "mais palavras-chave" em uma previsão de receita defensável que seu líder de growth pode efetivamente aprovar.
Erros Comuns
- Otimizar para strings, não entidades. Se seu pipeline de extração para na Camada 1, você ainda está fazendo keyword stuffing — só com ferramentas melhores.
- Ignorar sinais de menção de marca. Backlinks correlacionam apenas ~0,27 com probabilidade de citação por IA; menções de marca no YouTube correlacionam ~0,74. Se sua estratégia de extração não rastreia onde e como sua marca é mencionada em conteúdo de vídeo e comunidades, você está otimizando o sinal errado.
- Pular a análise de gaps competitivos. A maior alavanca da Cortex não foram novas palavras-chave — foram os subtópicos nos quais concorrentes já ranqueavam e eles não cobriam.
- Tratar extração como projeto único. A linguagem do comprador muda a cada trimestre. Pipelines precisam de re-execuções programadas, não atualizações anuais.
- Não taguear estágio de funil. Uma lista de palavras-chave sem classificação de intenção apenas empurra o problema de priorização para seus redatores.
Por Que Isso Importa Especificamente para Busca com IA
AI Overviews agora aparecem em mais da metade de todas as consultas do Google, alcançando 1,5 bilhão de usuários por mês. Neste walkthrough de estratégia SEO para a era ChatGPT em 2026, a lição central alinha-se exatamente com o que os dados de extração mostram: motores citam marcas cujas entidades e menções são estruturalmente claras na web, não marcas com mais backlinks. Extração de palavras-chave que para em métricas de volume estilo Google perde isso completamente — as camadas de entidade e intenção são o que faz você ser citado dentro de uma resposta gerada por IA, não apenas ranquear na primeira página.
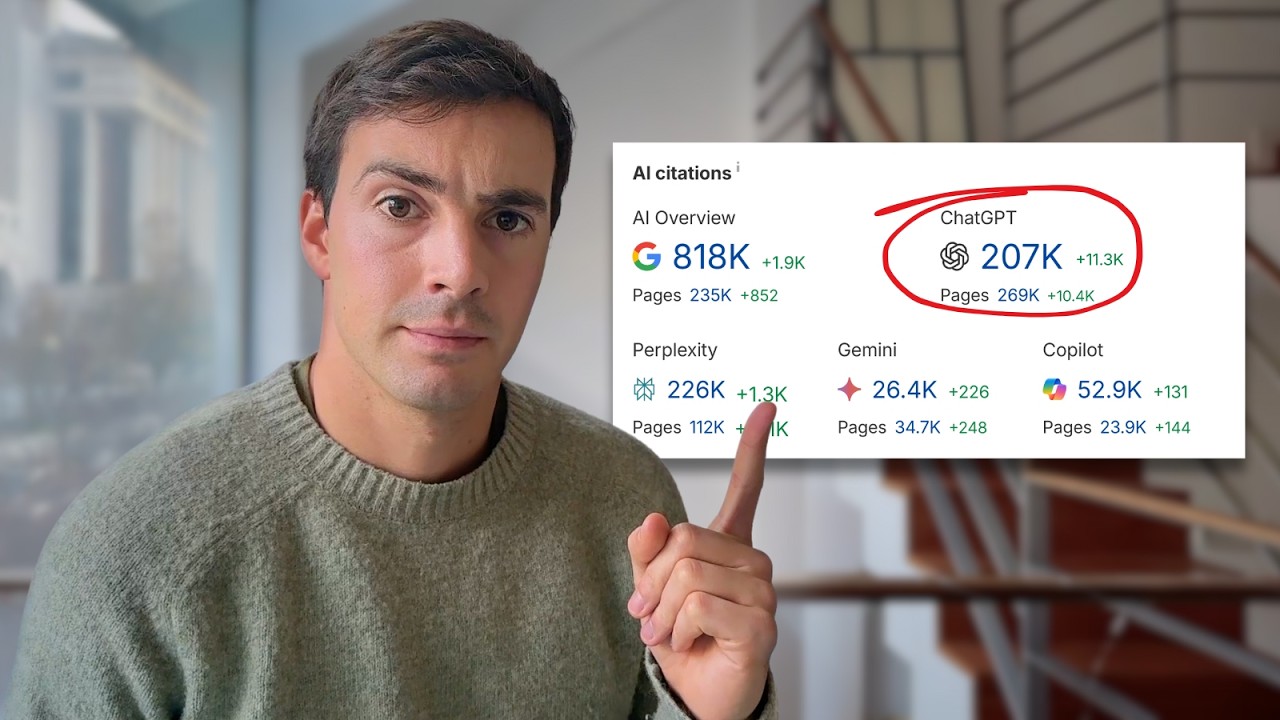 Assista: 「My ChatGPT AI SEO Strategy (works in 2026)」 — sobre sinais de menção de marca e entidades para visibilidade em busca com IA.
Conclusão
Extração é infraestrutura, não uma tarefa pontual de pesquisa. Construa o pipeline de 4 camadas uma vez — filtragem estatística, embedding semântico, reconhecimento de entidades, raciocínio LLM — e toda decisão downstream de conteúdo, SEO e GEO fica mais rápida e defensável. Lyzr e Cortex não superaram seus concorrentes escrevendo mais; eles estruturaram melhor. Inicie um projeto com o Agente SEO/GEO do Concat Pro para rodar esse pipeline no contexto do seu próprio produto e mercado.
Referências
- Concat Pro — Agente SEO/GEO
- Concat Pro — Calculadora de Taxa de Conversão
- YouTube — 「My ChatGPT AI SEO Strategy (works in 2026)」